← BibliothèqueToutes les vidéos
Tech.Rocks Summit 2024
Efficacité des applications du point de vue matériel
- Vincent Casillas (VP R&D System & Software, SiPearl)
Tech.Rocks Summit 2024 · 2 décembre 2024 · 33 min · en français
Résumé
L'IA étant désormais omniprésente, Vincent Casillas s'interroge sur l'impact de ces nouvelles applications sur l'ensemble de l'écosystème. L'efficacité n'est pas qu'une question de développement logiciel : elle commence par la conception matérielle des systèmes et des composants, passe par le bon écosystème logiciel, et l'optimisation des applications suppose de connaître les capacités du matériel.
L’essentiel
Vincent Casillas, VP R&D System & Software de SiPearl, raconte la construction d’un microprocesseur européen et défend l’intérêt d’un CPU doté de mémoire HBM pour l’inférence des modèles d’IA, avant de donner des conseils pour mieux exploiter le matériel.
Pour discuter du choix du matériel (CPU, GPU) selon les charges de travail d’IA et de l’optimisation du code pour ce matériel.
Les idées clés
- Le semi-conducteur demande de la résilience. Partie d’une initiative européenne de 2017 pour des solutions souveraines de calcul haute performance, la société a été créée mi-2019. Un microprocesseur demande 3 à 4 ans de développement, 7 mois entre le lancement d’un prototype en usine et sa réception, et des centaines de millions d’euros avant tout produit à vendre. à 2:41
- Un CPU avec HBM pour l’inférence. Selon lui, un accélérateur conçu pour un modèle serait obsolète à sa sortie, alors qu’un CPU généraliste s’adapte mieux. Selon lui, l’inférence est limitée par la bande passante mémoire ; sur des CPU x86 identiques, la HBM apporte par rapport à la DDR un speed-up de 1,5 à 2 fois au chargement des modèles (optimum autour de 13 à 15 milliards de paramètres) et de 1,5 à 2,5 fois en inférence selon le modèle. à 9:45
- Mieux exploiter son matériel. Il recommande d’abord d’identifier sa charge de travail (compute bound ou memory bound) pour choisir le matériel adapté, puis d’utiliser des frameworks et librairies qui exploitent ce matériel (unités vectorielles, parallélisme), et seulement en dernier d’optimiser son code. à 21:06
Questions pour votre équipe
- Nos traitements d’IA sont-ils plutôt limités par le calcul ou par la mémoire ?
- Nos GPU sont-ils bien utilisés, ou surdimensionnés pour certains usages ?
- Nos librairies exploitent-elles vraiment les capacités de notre matériel ?
L’intervenant travaille chez SiPearl, qui développe le CPU avec HBM qu’il présente comme solution ; le produit n’était pas encore disponible (prototypes annoncés pour 2025). Les chiffres de speed-up proviennent de mesures sur x86 dont la source n’est pas détaillée.
Chapitres
Summary
With AI now everywhere, Vincent Casillas looks at the impact of these new applications on the whole ecosystem. Efficiency is not only a matter of software development: it starts with the hardware design of systems and components, relies on the right software ecosystem, and optimising applications requires knowing what the hardware can do.
Thèmes : IA · Cloud, infra & ops
Transcript complet
Transcription automatique, à relire : les noms propres peuvent être mal orthographiés.
On continue notre aventure. Le tout est plus grand que la somme des parties. Ça, c'est aussi une manière d'appréhender l'approche systémique. Vous savez bien, il y a les éléments et la relation qui se tissent entre les éléments d'un système. C'est pour ça que le tout est plus grand que la somme des parties. Et aujourd'hui, dans le monde de l'intelligence artificielle, cette maxime, elle prend évidemment tout son sens. L'efficacité des applications ne réside pas seulement dans le développement de logiciels, mais bien dans l'harmonie entre le matériel, le logiciel et l'écosystème qui le soutient, l'homme faisant bien évidemment partie de cet écosystème. Et c'est Vincent Casillas, qui n'a rien à voir avec un gardien de but de l'équipe espagnole, je tiens à le dire, qui est VP R&D Software chez SiPearl, qui va nous guider dans l'univers absolument fascinant de l'optimisation des applications. Accueillons Vincent Casillas pour une session éclairante, acte 1, scène 7. Vincent, bienvenue.
Merci. Et voici la zapette. A tout à l'heure. Alors, on va démarrer. Donc moi, on a eu plein de talks très intéressants sur les plateformes, sur la partie logicielle, sur comment déployer une application. Moi, je vais vous parler de l'autre côté. Du système. Donc en fait, plutôt la partie hardware, plutôt la partie matériel, plutôt la partie accélérateur, microprocesseur. Et quel est le lien avec la résilience? En fait, la résilience, je vais l'aborder de trois points de vue. Le premier, ça va être très personnel. Moi, je suis tombé dans l'informatique quand j'avais 7-8 ans. J'ai découvert ça. Et du coup, c'est toujours quelque chose que j'ai voulu faire. J'ai voulu développer du matériel, développer des microprocesseurs. Et le fait est que j'ai fait du soft pendant presque 20 ans. Avant d'arriver jusqu'à chez SiPearl, où là, on développe un microprocesseur.
Et cette partie résilience, elle s'applique aussi à la société en elle-même. Parce que développer une startup ou une scale-up dans un domaine du semi-conducteur en Europe, c'est quelque chose qui est extrêmement compliqué. C'est compliqué. parce qu'on n'est pas habitué à ces cycles de développement de produits. On a oublié à quel point c'était complexe de développer un microprocesseur haute performance et le temps que ça prenait. Et donc, si on reprend, en fait, l'histoire de SiPearl, c'est quoi? C'est en fait en 2017 une initiative européenne de développer des solutions souveraines de calcul haute performance. Et calcul haute performance, ça implique microprocesseurs, mais aussi accélérateurs. Et donc en 2017, il y a cette initiative. Philippe Noton, le CEO de la compagnie, qui était à l'époque chez Atos, décide de créer un consortium pour développer ces technologies en Europe.
Donc 2018, le projet est gagné par ce consortium-là, et on en arrive en fait à 2019, mi-2019, où la société Cyper se crée. Et donc si on prend... Juste cette période-là, il a fallu quasiment deux ans entre l'idée, le concept et le fait d'avoir la société créée. Et donc les premières ressources qui arrivent début 2020 pour développer ce microprocesseur européen. Donc là, en fait, on démarre l'aventure avec les premiers recrues. Et c'est là où on découvre, où on se rend compte de ce qu'on est en train de faire. De ce qu'on est en train de faire, et c'est d'une complexité telle qu'on a... besoin de centaines d'ingénieurs avec des compétences très diverses qu'on n'a plus en Europe. Et donc là, c'est le marathon du recrutement, de la formation, de chercher des talents et en même temps de chercher des financements.
Parce que développer un microprocesseur, en fait, C'est des centaines de millions d'euros de financement avant même qu'on ait un produit à vendre. Le cycle de développement d'un microprocesseur, c'est 3-4 ans. C'est la phase de design, un an, un an et demi de design. La phase de production, on n'est pas sur du soft. Il faut produire le matériel. Il faut aller en usine. Il y a 7 mois de lead time entre le moment où on décide de lancer le prototype et le moment où on le reçoit. Et donc, c'est un modèle qui est difficile à vendre et difficile à expliquer. Et donc, on en arrive en fait à la complexité, la résilience, où on doit s'adapter pour trouver des solutions, pour trouver des solutions. des partenaires qui vont nous soutenir pour trouver des projets collaboratifs et pour avoir en fait en 2023 le premier deal qui est signé en fait avec notre processeur qui va être dans le premier système Exascale européen.
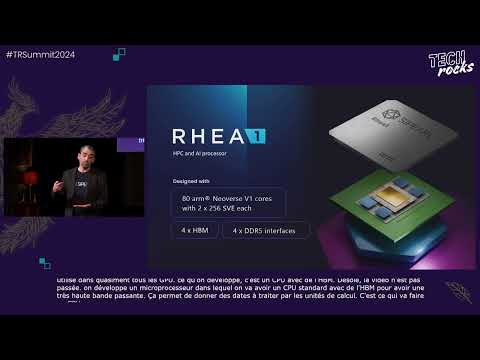
Donc tout ça pour dire que monter une scale-up dans le semi-conducteur en Europe, c'est de la résilience. Et c'est de la résilience de tous les jours. Donc, juste en quelques mots, qu'est-ce que c'est Cyperl? En fait, c'est une société qui est fabless. On développe un processeur très haute performance. Donc, en gros, nos équivalents, ça va être de l'Intel, de l'AMD, du Nvidia sur la partie CPU. Aujourd'hui, on est plus de 200 sur 6 sites. On a dû former des tas de personnes, redévelopper des compétences qui n'existaient plus en Europe. Et donc tout ça pour fabriquer ce microprocesseur. Et donc, si on regarde en fait ce qu'apporte notre microprocesseur, en fait, il a trois axes principaux. Donc, c'est un microprocesseur qui pourrait être utilisé sur de l'EI. Donc, je vais en parler un petit peu plus longuement tout à l'heure. Il est basé sur des technologies ARM. Potentiellement plus efficace que les Legacy X86.
Et l'autre gros palier de notre offre, c'est aussi la souveraineté. Donc il y a un gros focus. Sur l'IA, des applications d'IA, c'est très bien de développer les technologies logicielles, mais il faut du hardware sous-jacent. Et donc la troisième partie de la résilience, ça va être plutôt sur la partie technique. Je vais faire un petit débrief sur la partie hardware pour vous donner quelques bases. Aujourd'hui, quand vous faites de l'IA, vous avez forcément un GPU. Un GPU, c'est des unités de calcul avec des mémoires de type HBM. La HBM, c'est de la mémoire haute bande passante. C'est un empilement de modules de mémoire qui vont venir se mettre à côté du die de compute et qui vont permettre de donner les données aux unités de calcul. Et donc, si on regarde en fait là, c'est un petit diagramme qui explique l'empilement des DDR. Et le gros avantage de la HBM, c'est qu'elle a une très haute bande passante pour une efficacité énergétique qui est bien meilleure que les RAM standards.
Et donc, c'est ce qui est utilisé dans quasiment tous les GPU. Et aujourd'hui, chez SiPearl, nous ce qu'on développe, c'est un CPU avec de la HBM. Ah, désolé, la vidéo n'est pas passée. Bon, c'est pas grave, il n'y aura pas la vidéo. Donc, qu'est-ce qu'on fait, en fait, nous? On développe, en fait, un microprocesseur dans lequel on va avoir un CPU standard, mais couplé avec de l'HBM pour avoir une très haute bande passante. Et l'avantage de cette très haute bande passante, c'est que ça permet de donner les datas à traiter par les unités de calcul. Et c'est ce qui va faire qu'un CPU avec de la HBM pourra être utilisé dans un certain nombre de use cases. Et des fois, ça peut être plus intéressant d'avoir un CPU qu'un GPU. Donc, juste pour vous expliquer un peu la complexité de faire un CPU. En fait, aujourd'hui, un CPU, c'est une couche de package, un interposer, des dies et des stacks de HBM.
Et donc tout ça, en fait, ça vient s'assembler dans des usines pour faire un CPU et pour le mettre après dans vos serveurs et utiliser les CPU pour différentes applications de supercalculateurs ou des H. Donc passons maintenant à la partie plutôt... Pardon. Passons plutôt à la partie maintenant, pourquoi un CPU avec de l'HBM peut être une solution résiliente sur des applications de type AI. Donc, je vais passer très vite sur les LLM, tout le monde en entend parler. Ça peut s'utiliser dans plein de use cases différents. Ça va changer la manière dont tout le monde va faire son travail, que ce soit dans l'éducation, dans la finance, dans la sécurité, dans les milieux scientifiques. Donc c'est quelque chose qui évolue extrêmement rapidement.
Et la complexité, je vous ai dit tout à l'heure que développer un CPU ou un GPU, c'est quelque chose qui va prendre 3-4 ans. Entre le moment où on décide d'une idée et d'une architecture et le moment où c'est disponible sur le marché, il y a 4 ans. Et ça ne matche pas du tout avec les développements logiciels, l'évolution des modèles, qui va changer tous les ans. On va avoir des dizaines de modèles qui vont sortir par an. Et on ne peut pas dire qu'on fait un accélérateur spécifique pour un modèle, parce qu'une fois qu'il sera sur le marché, il sera déjà obsolète. Et donc un CPU qui est très généraliste va potentiellement s'adapter plus facilement à la technologie et l'évolution de la technologie. Donc là, on voit la variété de LLM qui existe, où on voit que tous les ans, il y a des nouveaux modèles qui apparaissent, avec de plus en plus de paramètres en entrée et de plus en plus de données à traiter. Et donc, un CPU avec de la HBM va permettre d'être plus résilient. Donc, si on regarde un peu l'évolution des modèles, en quelques années, on est passé de modèles qui faisaient quelques millions de paramètres à des dizaines de milliards de paramètres.
Et c'est quelque chose qui va continuer à s'accélérer et qui va continuer à évoluer. On target qu'à peu près aux alentours de 2029-2030, les modèles auront appris quasiment avec tous les paramètres disponibles à ce moment-là. Et donc traiter ce type de modèle avec des solutions qui ne sont pas forcément efficaces énergétiquement ou efficaces tout court, ça va poser des problèmes. Donc, juste pour résumer, en fait, on va avoir... deux types de modèles. Donc les modèles à très large nombre de paramètres et des modèles avec un nombre de paramètres beaucoup plus petit. Ce qui est important de savoir, c'est que suivant votre application, ce n'est pas toujours la même solution qui va être utilisée. On peut en fait, sur des modèles plus petits, utiliser plus facilement des CPU que des GPU. Donc, quand on va vouloir déployer un modèle, en fait, il va se poser tout un tas de questions.
Donc, est-ce qu'on va utiliser une solution GPU, son coût et sa disponibilité? On se rend compte que c'est de plus en plus difficile de sourcer des GPU, parce qu'il y a une demande qui est telle qui fait que si vous êtes petit, vous n'en aurez pas. Et donc, avoir des solutions alternatives, peut-être un peu moins efficaces, un peu moins rapides, ça va être très intéressant. L'autre question qui va venir se poser à tout le monde, c'est très bien, j'ai acheté ma ferme de 10 000 GPU, est-ce que je les utilise vraiment bien? Est-ce que ce n'est pas surdimensionné pour ce que j'ai besoin de faire? L'autre point, c'est que les CPU vont avoir une quantité de mémoire qui va être bien plus élevée que les GPU, et donc ça va permettre de faire autre chose que juste des LLM. L'efficacité énergétique, on n'en parlera pas beaucoup plus que ça. les requirements marketing et la souveraineté.
Donc maintenant, si on rentre un peu plus dans le détail dans les LLM. Les LLM, on va les catégoriser en deux grosses parties. Il va y avoir la partie training et la partie inférence. Et même dans la partie inférence, on va pouvoir en fait... Catégoriser ça en deux phases. On va avoir la première phase qui va être le préfil, qui va permettre de donner le premier token, donc la première réponse. Cette phase-là va avoir des caractéristiques un peu différentes de la phase de décodage qui va permettre de donner les tokens suivants. Et donc, si on regarde, on fait du LLM, on a trois grosses caractéristiques. Et ces trois grosses phases vont avoir des caractéristiques qui vont être différentes. Si on prend la partie training, ça va être vraiment axé sur le compute. Donc c'est là où les GPU vont être les meilleurs.
C'est là où on va traiter des dizaines ou des milliers de paramètres en parallèle pour faire cette phase de training. Et donc, ce qu'on voit, c'est que c'est une phase qui va nécessiter du compute, de la bande passante, de la bande passante réseau, de la capacité mémoire. La phase d'inférence, elle, va avoir des caractéristiques un peu différentes. va être très memory bandwidth bound. C'est-à-dire qu'elle va avoir besoin de récupérer énormément de data et pas forcément faire beaucoup de compute. Et donc ce sont des caractéristiques qui ne s'appliquent pas forcément au GPU. Et donc la troisième phase, ça va être la phase de décode, c'est la phase de préfile, qui elle va avoir besoin d'une réactivité très forte. Et donc ça va être très compute bound. Une fois qu'on a dit ça sur ces trois types de phases sur les LLM, la question va se poser de qu'est-ce qu'on utilise sur quelle phase?
Et pourquoi on utiliserait un CPU plutôt qu'un GPU ou vice-versa? Donc là, je vais juste vous donner quelques chiffres sur la différence entre utiliser un type de mémoire par rapport à un autre type de mémoire. Donc c'est des chiffres qui ont été faits sur des CPU x86 qui ont exactement la même architecture, les mêmes cœurs, et juste ils utilisent des mémoires de type différentes. Et là, ce qu'on voit, c'est qu'en fonction du nombre de paramètres, on va avoir un speed-up de 1,5 à 2 fois en utilisant de la mémoire de type HBM versus de la mémoire DDR. Et donc ça, c'est juste sur la phase de chargement des modèles. Et donc, là où ça va être le plus efficace, ça va être pour des modèles autour de 13-15 milliards de paramètres, où la capacité mémoire en HBM va être suffisante pour absorber ces données. Dès qu'on va monter sur des modèles beaucoup plus gros, l'HBM ne réussira pas à avoir ce type de performance.
Maintenant, si on regarde sur la partie inférence, sur une inférence simple, on va avoir aussi des ratios de speed-up avec de la HBM qui vont être autour de 1,5 à 2 fois, à 2,5 fois suivant le type de modèle. Ce qui est important de voir, c'est que ça c'est sur une inférence unique, mais avec les CPU modernes, on est capable de faire des badges d'inférence et de bénéficier de la haute bande passante que l'on a sur les mémoires pour accélérer ces transferts. Donc ça, c'est un autre speed-up. On voit qu'on est autour de 1,5 et 2 en termes de speed-up avec de l'HBM. Donc, si je résume la situation actuelle, aujourd'hui, les LLM, quasiment tous, fait sur du GPU. Que ce soit la phase d'inférence, la phase de training, il n'y a que la partie« sanitize» qui se fait un peu sur du CPU.
Et... Si on regarde les speed-up qu'on a avec les CPU avec HBM, on se rend compte qu'ils pourraient être utilisés sur d'autres phases. On voit que, par exemple, sur la partie inférence, un CPU avec HBM a de grosses facultés pour traiter cette inférence avec un coût d'acquisition qui est bien inférieur. Une consommation qui est inférieure à des GPU et une meilleure efficacité, ce qui en fait une solution clairement résiliente. Et donc, dans le futur, il se pourrait très bien qu'on ait des CPU qui permettent de faire de l'inférence. Donc, en termes de... Qu'est-ce qu'on peut faire avec un CPU avec de la HBM? Clairement, le premier use case de l'inférence. Il est vraiment adapté pour faire de l'inférence et traiter des batchs de données avec sa haute bande passante.
On peut faire aussi un peu de pré-processing. Ça permet en fait de... Vu qu'il est flexible et qu'il permet de faire n'importe quel type d'opération, en fait on peut aussi s'en servir pour faire du pré-processing. On peut s'en servir dans certaines phases du training. Clairement, en fait, un CPU, ce n'est pas fait pour faire du training. Par contre, pour raffiner un modèle, où on a déjà fait toute la première phase de training sur les datas, là ça peut être efficace parce qu'on vient juste raffiner ce modèle. Et le dernier point où un CPU peut être intéressant, ça va être quand on a un petit use case. qu'on n'a pas besoin d'investir sur une ferme de calcul avec des GPU, on a juste besoin d'utiliser un tout petit modèle et de le faire évoluer. Donc, si on en vient à la conclusion, je vous ai parlé un peu de hardware, de caractéristiques des mémoires entre l'HBM et la DDR.
Donc on va avoir d'un côté la DDR, les mémoires de type classique, qui vont être intéressantes sur les CPU, sur des petits modèles inférieurs à 1 milliard. Pourquoi? Parce que c'est une mémoire qui a... Une caractéristique qui a une faible latence et pas forcément énormément de bandes passantes, mais le fait d'avoir une faible latence va compenser la bande passante tant qu'on sera sur des modèles inférieurs à un milliard. Dès qu'on va passer sur des modèles avec un certain nombre de paramètres bien plus élevés, là, la bande passante va jouer son rôle et va permettre d'accélérer les traitements. Et donc, après, il y a tout le monde, toute la partie, dès qu'on va dépasser les 100 milliards, qu'on va arriver au trillion de paramètres, où là, on rentre dans un monde où on va changer de paradigme encore. Ce sera très certainement un mix entre du CPU, des accélérateurs dédiés, des CPU pour pouvoir cadencer et utiliser correctement ces ressources hardware.
Et donc, pour en revenir à ce que vous faites au quotidien, quand vous développez des plateformes, quand vous développez des applications, quand vous mettez en production des services, qu'est-ce que vous pouvez faire, vous, à votre niveau, pour vraiment être... Utiliser efficacement les ressources que vous avez à votre disposition. Ce n'est pas forcément quelque chose d'évident, mais la première chose à faire, c'est vraiment d'identifier votre workload, savoir ce que vous allez faire, c'est quoi votre algorithme, est-ce qu'il est compute bound, est-ce qu'il est memory bound, et en fonction de ce que vous avez à faire, de choisir en fait. La partie hardware qui va fiter au mieux à votre besoin. La deuxième chose qui est importante, c'est aussi d'utiliser les frameworks, les librairies qui sont adaptées à votre hardware. Souvent, vous pouvez prendre... N'importe quel type de librairie, ça fonctionnera, il n'y aura pas de souci.
Par contre, est-ce que vous serez vraiment en train d'utiliser les capacités de votre processeur, de votre accélérateur? Est-ce que vous serez en train de vraiment utiliser les unités vectorielles? Est-ce que vous serez en train de paralléliser au maximum votre code sur votre hardware? Une des meilleures façons de le savoir, c'est vraiment de choisir ce que vous utilisez. Et la dernière partie, qui est quelque chose d'encore plus complexe, c'est après, c'est d'aller optimiser votre code. D'optimiser votre code pour votre hardware. C'est vraiment la dernière chose à faire quand vous voulez vraiment tirer le maximum de votre hardware. Donc moi, j'ai fini là. On ne me dit rien, alors je ne suis pas prête. Heureusement, j'étais juste derrière.
Vous avez remarqué quand même. Voilà, bien sûr. Je ne vous laisse pas complètement tomber non plus, puisque maintenant, on a le droit à 10 minutes de questions et de réponses. C'est tout l'intérêt du sujet. Alors, on a une première question au milieu du public. Et vous êtes extrêmement bien placé parce que là, on vous voit lever la main. Et ça, c'est assez merveilleux. Donc, je ne vois pas si c'est Amélie ou pas. Oui, si, pardon. Toujours Amélie qui donne le micro. Voilà. Merci pour la présentation. Comment se compare l'architecture de SiPearl avec ce que fait Apple, par exemple, sur les M1, M2, M3? Qui supportent bien justement les SLM aussi aujourd'hui? Alors, nous, on est sur une architecture ARM. Donc, on est sur des cœurs, en fait, de type V1. Donc, c'est des NeoVerse V1. Donc, Apple a développé ses propres cœurs. Donc, nous, on n'est pas sur le développement. du cœur en lui-même, on est sur une architecture qui va être plus orientée serveur.
Donc on va être sur des processeurs de la gamme très haute performance avec de la HBM dans le package. Donc ça va être quelque chose qui va consommer du 400 watts par CPU, qui est vraiment... au-dessus de ce que fait Apple. Pas forcément sur la performance pure du CPU, puisqu'on n'est pas Apple, on a 4 ans, mais on va être sur le même type d'architecture. Est-ce que ceci répond à la question ? Tout à fait, très bien. Y a-t-il une autre question? Alors devant, troisième rang, merci Amélie. Merci Vincent. Il me semble que tu as oublié une information. Donc là, vous êtes en cours de développement. Tout à fait. Quand est-ce que vous sortez le produit? Le produit arrive en proto l'année prochaine. On a passé 3-4 ans à développer les compétences, développer les équipes. Faire toute la phase de design et là on est en phase finale, on va lancer les protos et courant 2025 on aura les CPU qui reviendront et on pourra faire des démonstrations.
Merci beaucoup. Une autre question? D'abord, monsieur, et après, ce sera vous. Merci. Pour revenir sur les cycles, j'ai une question. Finalement, ce que tu expliquais, c'est que les cycles de développement sont beaucoup plus courts que... Finalement, en tant que quatre mois, c'est trop long, on a une espèce de rythme, un peu de folie. Comment tu fais? Comment vous faites? Qu'est-ce qui change dans le recrutement, dans la motivation de personnes qui doivent s'impliquer sur 3, 5, 10 ans avant de voir quelque chose qui change le monde? C'est une excellente question. Comment on fait pour les motiver, pour faire en sorte qu'ils soient investis sur une si longue durée? La première chose, c'est pendant le recrutement, c'est on leur explique. Moi, je leur explique toujours ce que ça veut dire de développer un processeur. Je leur explique que quand ils vont rentrer, ils vont passer trois à six mois à ne rien comprendre. C'est la première chose que je leur explique. Je leur explique que pendant six mois, ils vont être en phase de ramp-up.
Parce que c'est des technos tellement avancés, moi je ne peux pas trouver un formateur qui va me dire« je vais faire venir quelqu'un qui va faire pendant deux jours expliquer ce qu'on fait». Non, il faut que pendant six mois, il soit là à travailler. Et quand on parle en fait de... De durée en fait et de manière de travailler. Aujourd'hui, nous, moi dans mes équipes, j'ai des gens en fait qui pour lancer une session de debug, en fait, ils doivent attendre 4 heures. 4 heures pour avoir les résultats sur leurs problèmes. Donc ce que je leur explique aussi, c'est qu'il va falloir être patient, messieurs et mesdames. Il va falloir être très patient parce que c'est une autre façon de travailler. On n'est pas, en fait, j'ai pas la plateforme sur le bureau, j'ai pas mon système embarqué, je débug en temps réel ce qui se passe. Je lance ma simu, je lance mon job, et j'attends 4 heures, et je fais ma phase de débug, donc je fais peut-être 2 itérations par jour.
Donc voilà, c'est que de l'explication et d'être clair sur ce que ça va représenter de travailler chez SiteLab et de travailler sur ce type de techno. Vous n'avez pas terminé la réponse, si. Si, si, parce que monsieur, j'aime beaucoup votre chemise, je tiens à spécifier. On va me donner l'adresse. Bonjour. Une petite question. Vous parliez de récupérer la souveraineté sur le design du microprocesseur. Tu as la fonderie, je suppose, sur TSMC? Voilà, TSMC. Donc il n'y a pas de plan pour rapatrier ça en Europe comme le fait actuellement Intel, Hostage, je ne sais pas trop quoi. Alors nous on serait ravis de faire la prod en Europe, sauf qu'aujourd'hui il n'y a pas d'usine. Il n'y a pas d'usine sur ces technos. Donc on est sur des technos avancés, sur du 6 nano, sur du 3 nano à l'avenir. Aujourd'hui, Il y a quelques fabs qui le font, il y a TSMC, il y a Samsung et il y a Intel Foundries. Donc tant qu'il n'y aura pas des dizaines de milliards qui seront mis sur la table pour avoir une usine en Europe, on fera produire où il y a la capacité de produire.
Ce qui est d'ailleurs très dommage parce qu'aujourd'hui les machines qui sont utilisées chez TSMC viennent d'Europe. Je crois qu'il y avait une autre question aussi, là-bas, monsieur. Merci. 1891, le théâtre, on l'a dit ce matin. Comment ça se passe pour préparer la partie logicielle? Par exemple, Nvidia a beaucoup marché grâce à CUDA et les drivers qui sont mis par le logiciel. C'est ce qui leur a permis un peu de gagner contre Intel. Comment vous préparez cette partie-là? Alors, le gros avantage d'être sur une architecture de type ARM et qu'on fait un CPU, donc un General Purpose Processor, c'est que l'écosystème est déjà là. C'est que nous, on ne développe pas un jeu d'instruction spécifique, on n'est pas sur une accélération où on aurait besoin d'avoir cet écosystème et cet écosystème logiciel. Moi, aujourd'hui, je prends n'importe quel soft ou n'importe quelle distribution qui tourne sur ARM, je suis capable de la faire tourner sur mon simulateur et à terme je serai capable de la faire tourner sur mon processeur.
Donc l'écosystème il est là. Il a fallu plus de dix ans à ARM pour développer cet écosystème. et faire en sorte que les applications tournent sur des processeurs de type A. Et tout l'effort qui est fait par la communauté pour avoir cet écosystème, ça nous bénéficie directement. Alors, y a-t-il une autre question pour Vincent dans la salle? Another one. Alors Amélie, c'est deuxième rang, troisième rang devant. Vincent, je pense que ce qui serait intéressant, peut-être pas aujourd'hui, on n'aura peut-être pas le temps, mais sur un prochain talk, c'est que tu nous expliques quelles sont les compétences nécessaires dans tes équipes, quels sont les différents types de devs, parce que tu as le hardware, celui qui va passer en fonderie, et une fois qu'il sera fondu, tu ne pourras plus rien modifier, mais que tu as du software au-dessus que tu peux modifier.
Et qu'en plus, actuellement, tu as des data scientists qui bossent aussi pour essayer de faire tourner l'IA sur votre CPU. Il me reste 2 minutes 25. Absolument. Je pense que je peux déjà l'expliquer. J'en ai parlé très rapidement. En fait, SiPearl... c'est des dizaines de métiers différents. Et quand je dis dizaines, on a peut-être 20 ou 30 métiers différents pour développer ce processeur. Donc il y a vraiment les équipes qui font le design hardware, qui font la vérification, qui font le back-end et qui permettent de faire le placement, le routage des différentes cellules dans le chip. Et à côté de ça, on a la partie que je gère plutôt, qui va être la partie software et système. La partie système, ça va être les équipes qui vont faire du design de carte mère, donc des équipes qui font du routage, du bring-up de carte, du design mécanique. Et on a la partie software. Et donc dans la partie software, je vais couvrir en fait...
Tout ce qui va du très bas niveau, qui va être des ROM, du code qui va s'exécuter, qui va être flashé dans le processeur, qui va être immuable au moment où on va lancer le tape-out, où on va lancer la production, jusqu'aux couches qui vont être plutôt du benchmark, de l'optimisation de librairie, des contributions dans les compilateurs, dans LLVM, dans GCC, des équipes kernel, des équipes BIOS, des équipes firmware. Donc j'ai un nombre de compétences qu'on doit staffer au sein de SiPearl qui est juste gigantesque. Et dont certains en fait sont des métiers où je ne trouve personne en Europe. Donc aujourd'hui par exemple je dois faire un BIOS. Tout le monde voit son BIOS sur son laptop. Par contre, est-ce que vous connaissez un ingénieur BIOS au sein de votre communauté? Moi, je n'en connaissais pas. Et donc, il a fallu qu'on recrute des gens, qu'on les forme en interne, qu'on s'auto-forme, qu'on apprenne ce qu'il fallait faire pour avoir ces compétences-là au sein de Cyper.
Et donc, ce n'est pas faute de chercher. Moi, j'ai cherché pendant des semaines et pendant des mois un team lead BIOS. Je suis encore en train de chercher depuis 4 ans. Éventuellement, si vous connaissez quelqu'un, n'hésitez pas. À le soumettre à Vincent, c'est aussi ça la force de la communauté, Vincent. Donc on en profite. Et sur le gong, fantastique. Merci beaucoup de SiPearl, et pas SiPearl. Merci. SiPearl, pardonnez-moi, Vincent.